Attention: Here be dragons
This is the latest
(unstable) version of this documentation, which may document features
not available in or compatible with released stable versions of Godot.
Checking the stable version of the documentation...
内部渲染架构
这个页面是对 Godot 4 内部渲染器设计的高阶概述。不适用于旧版本的 Godot。
本页面旨在记录各项设计决策,以使其最契合 Godot 的设计哲学,同时也为新的渲染贡献者提供一个入门的起点。
如果你有关于内部渲染的问题在此未得到解答,欢迎在 Godot 贡献者聊天的 #rendering 频道中进行提问。
备注
如果你在理解这个页面上的概念时遇到了困难,建议先过一遍 LearnOpenGL 等 OpenGL 教程。
想要高效地使用这些现代的底层 API(Vulkan、Direct3D 12、Metal),通常要求开发者具备对更高层 API(如 OpenGL、Direct3D 11)的中级理解。不过值得庆幸的是,贡献者极少需要直接与这些底层 API 打交道。Godot 的渲染器完全是基于 OpenGL 和 RenderingDevice 构建的,而 RenderingDevice 正是我们对 Vulkan、Direct3D 12 和 Metal 所做的一层抽象封装。
渲染方法
Forward+
这是一种前向渲染器,使用集群方法实现光照。
集群光照使用计算着色器将灯光按照 3D 视锥栅格进行分组。然后在渲染时,像素就能够查询影响某个栅格单元的有哪些灯光,仅对影响该像素的灯光进行光照计算。
这种方法能够大幅提升在桌面硬件上的渲染性能,但是在移动端会略为低效。
移动端
这是一种前向渲染器,采用了传统的单次遍历(single-pass)光照处理方式。在引擎内部,它被称为 Forward Mobile(移动端前向渲染) 。
针对移动平台设计,但是也能够在桌面平台运行。这种渲染方法针对移动 GPU 进行了优化。移动 GPU 的架构与桌面 GPU 有很大的区别,因为需要考虑电池使用、散热、读写数据时的总体带宽限制等约束。对计算着色器的支持也非常有限,甚至完全不支持。因此,移动渲染器单纯使用基于光栅的着色器(片段/顶点)。
与桌面 GPU 不同,移动 GPU 执行的是基于图块的渲染。整个图像不是作为整体渲染的,而是会细分为较小的图块,适合放置到移动 GPU 更快的内部存储中。图块单独渲染后就会写入到目标纹理上。图形驱动会自动进行这一步操作。
问题在于,这种做法会在我们的传统方法中造成瓶颈。对于桌面渲染,我们会先渲染所有不透明的几何体,然后处理背景,再处理透明的几何体,最后进行后期处理。每个步骤都需要将当前的结果读进图块内存,执行对应的运算后再写出。我们需要等待所有图块都完成后才能继续下一个阶段。
移动端渲染器的第一个重要改动是,它没有沿用桌面端渲染器(Forward+)所使用的 RGBA16-Float 纹理格式。除非启用了 rendering/viewport/hdr_2d 项目设置,否则它会使用 R10G10B10A2 UNORM 纹理格式。这一改动将所需的带宽减半,并且带来了进一步的优化,因为移动硬件通常会对 32 位格式进行专门的底层优化。其权衡之处在于,默认情况下,由于颜色数据的精度和最大数值范围降低,移动端渲染器的 HDR 能力受到了限制。
当启用项目设置中的 rendering/viewport/hdr_2d (2D HDR)时,移动渲染器(Mobile Renderer)会采用和 Forward+ 渲染器相同的 RGBA16F 格式来进行渲染。这样做虽然能够实现完整的 HDR 支持,但同时也会增加显存带宽的占用,并可能在移动端 GPU 或集成显卡上导致性能下降。
第二个重要更改就是尽可能使用子阶段(sub-pass)。子阶段能够按照图块来执行渲染步骤,节省每个渲染阶段之间读写图块带来的开销。使用子阶段带来的限制是无法读取相邻像素,因为我们只能针对单一图块进行处理。
子阶段的这一限制导致我们无法高效实现辉光、景深等特性。类似地,如果需要读取屏幕纹理或者深度纹理,我们就必须将渲染结果完全写出,限制对子阶段的使用。启用这种特性时,会混用子阶段和正常阶段,因此会带来明显的性能损失。
在桌面平台上,使用子通道(sub-passes)不会对性能产生任何影响。不过,得益于更低的复杂度和更少的带宽占用,这种渲染方法在简单场景中依然能比 Forward+ 表现得更好。这一点在低端显卡、集成显卡或者 VR 应用中尤其明显。
由于关注点在于低端设备,这种渲染方法并不提供 SDFGI、体积雾和雾体积等高端渲染特性。部分后期处理效果也不可用。
兼容
备注
这是使用 OpenGL 驱动时唯一可用的渲染方法。当使用 Vulkan、Direct3D 12 或 Metal 时,无法使用这种渲染方法。
这是一种传统的(非集群式)前向渲染器。在引擎内部,它被称为 GL Compatibility(GL 兼容模式) 。它主要是为那些不支持 Vulkan 的老款显卡准备的,但在较新的硬件上也能非常高效地运行。具体来说,它针对老旧和低端的移动设备进行了优化。不过,由于许多优化策略是通用的,它同样也是老旧和低端桌面设备的绝佳选择。
与“移动”渲染器类似,“兼容”渲染器在进行 3D 渲染时使用的也是 R10G10B10A2 UNORM 纹理。与移动渲染器不同的是,颜色都经过了色调映射,以 sRGB 格式存储,因此不支持 HDR。这样就不需要再执行色调映射阶段,能够使用低位纹理,不会产生明显的条带。
“兼容”渲染器在绘制带光照的对象时使用的传统的单阶段向前方法,但是带阴影的灯光会使用多阶段方法。确切地说,第一个阶段能够绘制多个不带阴影的灯光以及一个带阴影的 DirectionalLight3D。后续的各个阶段中,最多只能分别绘制一个带阴影的 OmniLight3D、 SpotLight3D、 DirectionalLight3D。带阴影的灯光对场景的影响与不带阴影的灯光不同,因为光照的混合使用的是 sRGB 空间而不是线性空间。这种区别会影响场景的外观,针对“兼容”渲染器设计场景时需要谨记于心。
鉴于其专注于低端设备,这种渲染方法并不提供高端的渲染功能(与移动端/Mobile 渲染模式相比,功能更是少之又少)。绝大多数后期处理效果都无法使用。
为什么不使用延迟渲染?
向前渲染通常能够在性能和灵活性之间达到更好的平衡,尤其是在灯光使用了集群方法的情况下。延迟渲染虽然在某些情况下更快,但是灵活性较低、使用 MSAA 需要特殊处理。MSAA 能够为非写实画风的游戏带来很大提升,因此我们选择在 Godot 4 使用向前渲染(Godot 3 也一样)。
话虽如此,向前渲染器中确实有一部分是使用延迟方法执行的,以便在可能的情况下进行一些优化。这一点尤其适用于 VoxelGI 和 SDFGI。
未来可能会开发集群延迟渲染器。这种渲染器可以在对性能的要求大于灵活性的场合使用。
渲染驱动
Godot 4 支持以下图形 API:
Vulkan
这是 Godot 4 的主要驱动,大部分开发集中在这个驱动上。
Vulkan 1.0 是必要的基准,Vulkan 1.1 和 1.2 的特性会有可用时使用。我们使用 volk 作为 Vulkan 加载器,使用 Vulkan Memory Allocator 进行内存管理。
使用 Vulkan 驱动时支持 Forward+ 和移动 渲染方法。
Vulkan 上下文的创建:
Direct3D 12 上下文的创建:
Direct3D 12
与 Vulkan 类似,Direct3D 12 驱动仅支持现代平台,是针对 Windows 和 Xbox 设计的(鉴于 Xbox 上无法直接使用 Vulkan)。
使用 Direct3D 12 时支持 Forward+ 和移动 渲染方法。
核心着色器 与 Vulkan 渲染器共享。 着色器是利用 Mesa NIR 技术,从 SPIR-V 转译为 DXIL 的 (了解更多详情).
这款驱动目前仍处于实验阶段,仅在 Godot 4.3 及更高版本中可用。虽然 Direct3D 12 能够支持 Windows 11 上一些独有的特性(比如窗口化优化和自动 HDR),但对于大多数项目来说,依然推荐使用 Vulkan。如果想了解更多详情,可以查看 pull request that introduced Direct3D 12 support 。
Metal
Godot 提供了一个原生的 Metal 驱动,它可以在所有 Apple Silicon 硬件(即搭载 ARM 架构芯片的 macOS 设备)上运行。与使用 MoltenVK 转译层相比,它的速度要快得多,尤其是在受 CPU 性能瓶颈限制的场景下。
Forward+ 和 Mobile(移动端)这两种 渲染方法 (渲染方法)都可以在 Metal 后端下使用。
核心着色器 (核心着色器)是与 Vulkan 渲染器共享的。这些着色器会通过 SPIRV-Cross 工具,从 GLSL 语言转译(Transpiled)为 MSL 。
Godot 也支持通过 MoltenVK 来进行 Metal 渲染。当原生的 Metal 支持不可用时(比如在 x86 架构的 macOS 系统上),它就会作为备用方案被启用。
从 Godot 4.7 版本开始,只要条件允许,引擎现在会使用 Metal 4。所有的 Apple Silicon 硬件(比如 M 系列芯片的 Mac 和新款 iPad)都支持 Metal 4,但前提是必须运行 macOS 26 或更高版本,以及 iOS 26 或更高版本的系统。在较旧的 macOS 和 iOS 版本上,引擎会自动降级使用 Metal 3 作为后备方案。如果想了解更多技术细节,可以查看 引入 pull request that introduced Metal 4 support 。
OpenGL
这个驱动使用 OpenGL ES 3.0,针对的是不支持 Vulkan 的旧有设备以及低端设备。桌面平台运行该驱动时使用的是 OpenGL 3.3 Core Profile,因为桌面平台的大部分图形驱动不支持 OpenGL ES。Web 导出使用的是 WebGL 2.0。
在桌面平台上,你可以通过传入 --rendering-driver opengl3_es 这个命令行参数,来直接使用 OpenGL ES 3.0。不过,这只有在那些原生支持 OpenGL ES 的显卡驱动上才能生效(比如 Mesa 驱动)。
使用 OpenGL 驱动是只能使用 兼容 渲染方法。
核心着色器 与 Vulkan 渲染器完全不同。
由于这款驱动程序首要针对的是低端设备,因此它并不支持许多高级特性。
渲染驱动/方法总结
目前可用的渲染 API + 渲染方法组合如下:
Vulkan + Forward+ (在 macOS 和 iOS 系统上,可选择通过 MoltenVK 来运行。)
Vulkan + Mobile (在 macOS 和 iOS 系统上,可选择通过 MoltenVK 来运行。)
Direct3D 12 + Forward+
Direct3D 12 + Mobile
Metal + Forward+
Metal + Mobile
OpenGL + 兼容模式(在 Windows 和 macOS 系统上,还可以选择通过 ANGLE 来运行)
每一种组合都有其各自的局限性和性能表现。因此,在提交拉取请求(pull request)之前,请务必尽可能在所有的渲染方法(rendering methods)上都测试一下你的改动。
RenderingDevice 抽象
备注
OpenGL 驱动不使用 RenderingDevice 抽象。
为了让现代底层图形 API 的复杂性变得更易于掌控,Godot 使用了它自己的一套抽象层,也就是 RenderingDevice。
这意味着,在编写现代渲染方法的代码时,你其实并不需要直接调用 Vulkan、Direct3D 12 或 Metal 的原生 API。虽然它的底层程度依然高于像 OpenGL 这样的 API,但这让开发渲染器的工作变得更容易了,因为 RenderingDevice 会帮你抹平(抽象掉)许多特定 API 的怪癖和差异。RenderingDevice 所提供的抽象层级,与 WebGPU 是相近的。
Vulkan RenderingDevice 实现:
Direct3D 12 RenderingDevice 的实现
Metal RenderingDevice 的实现:
核心渲染类架构
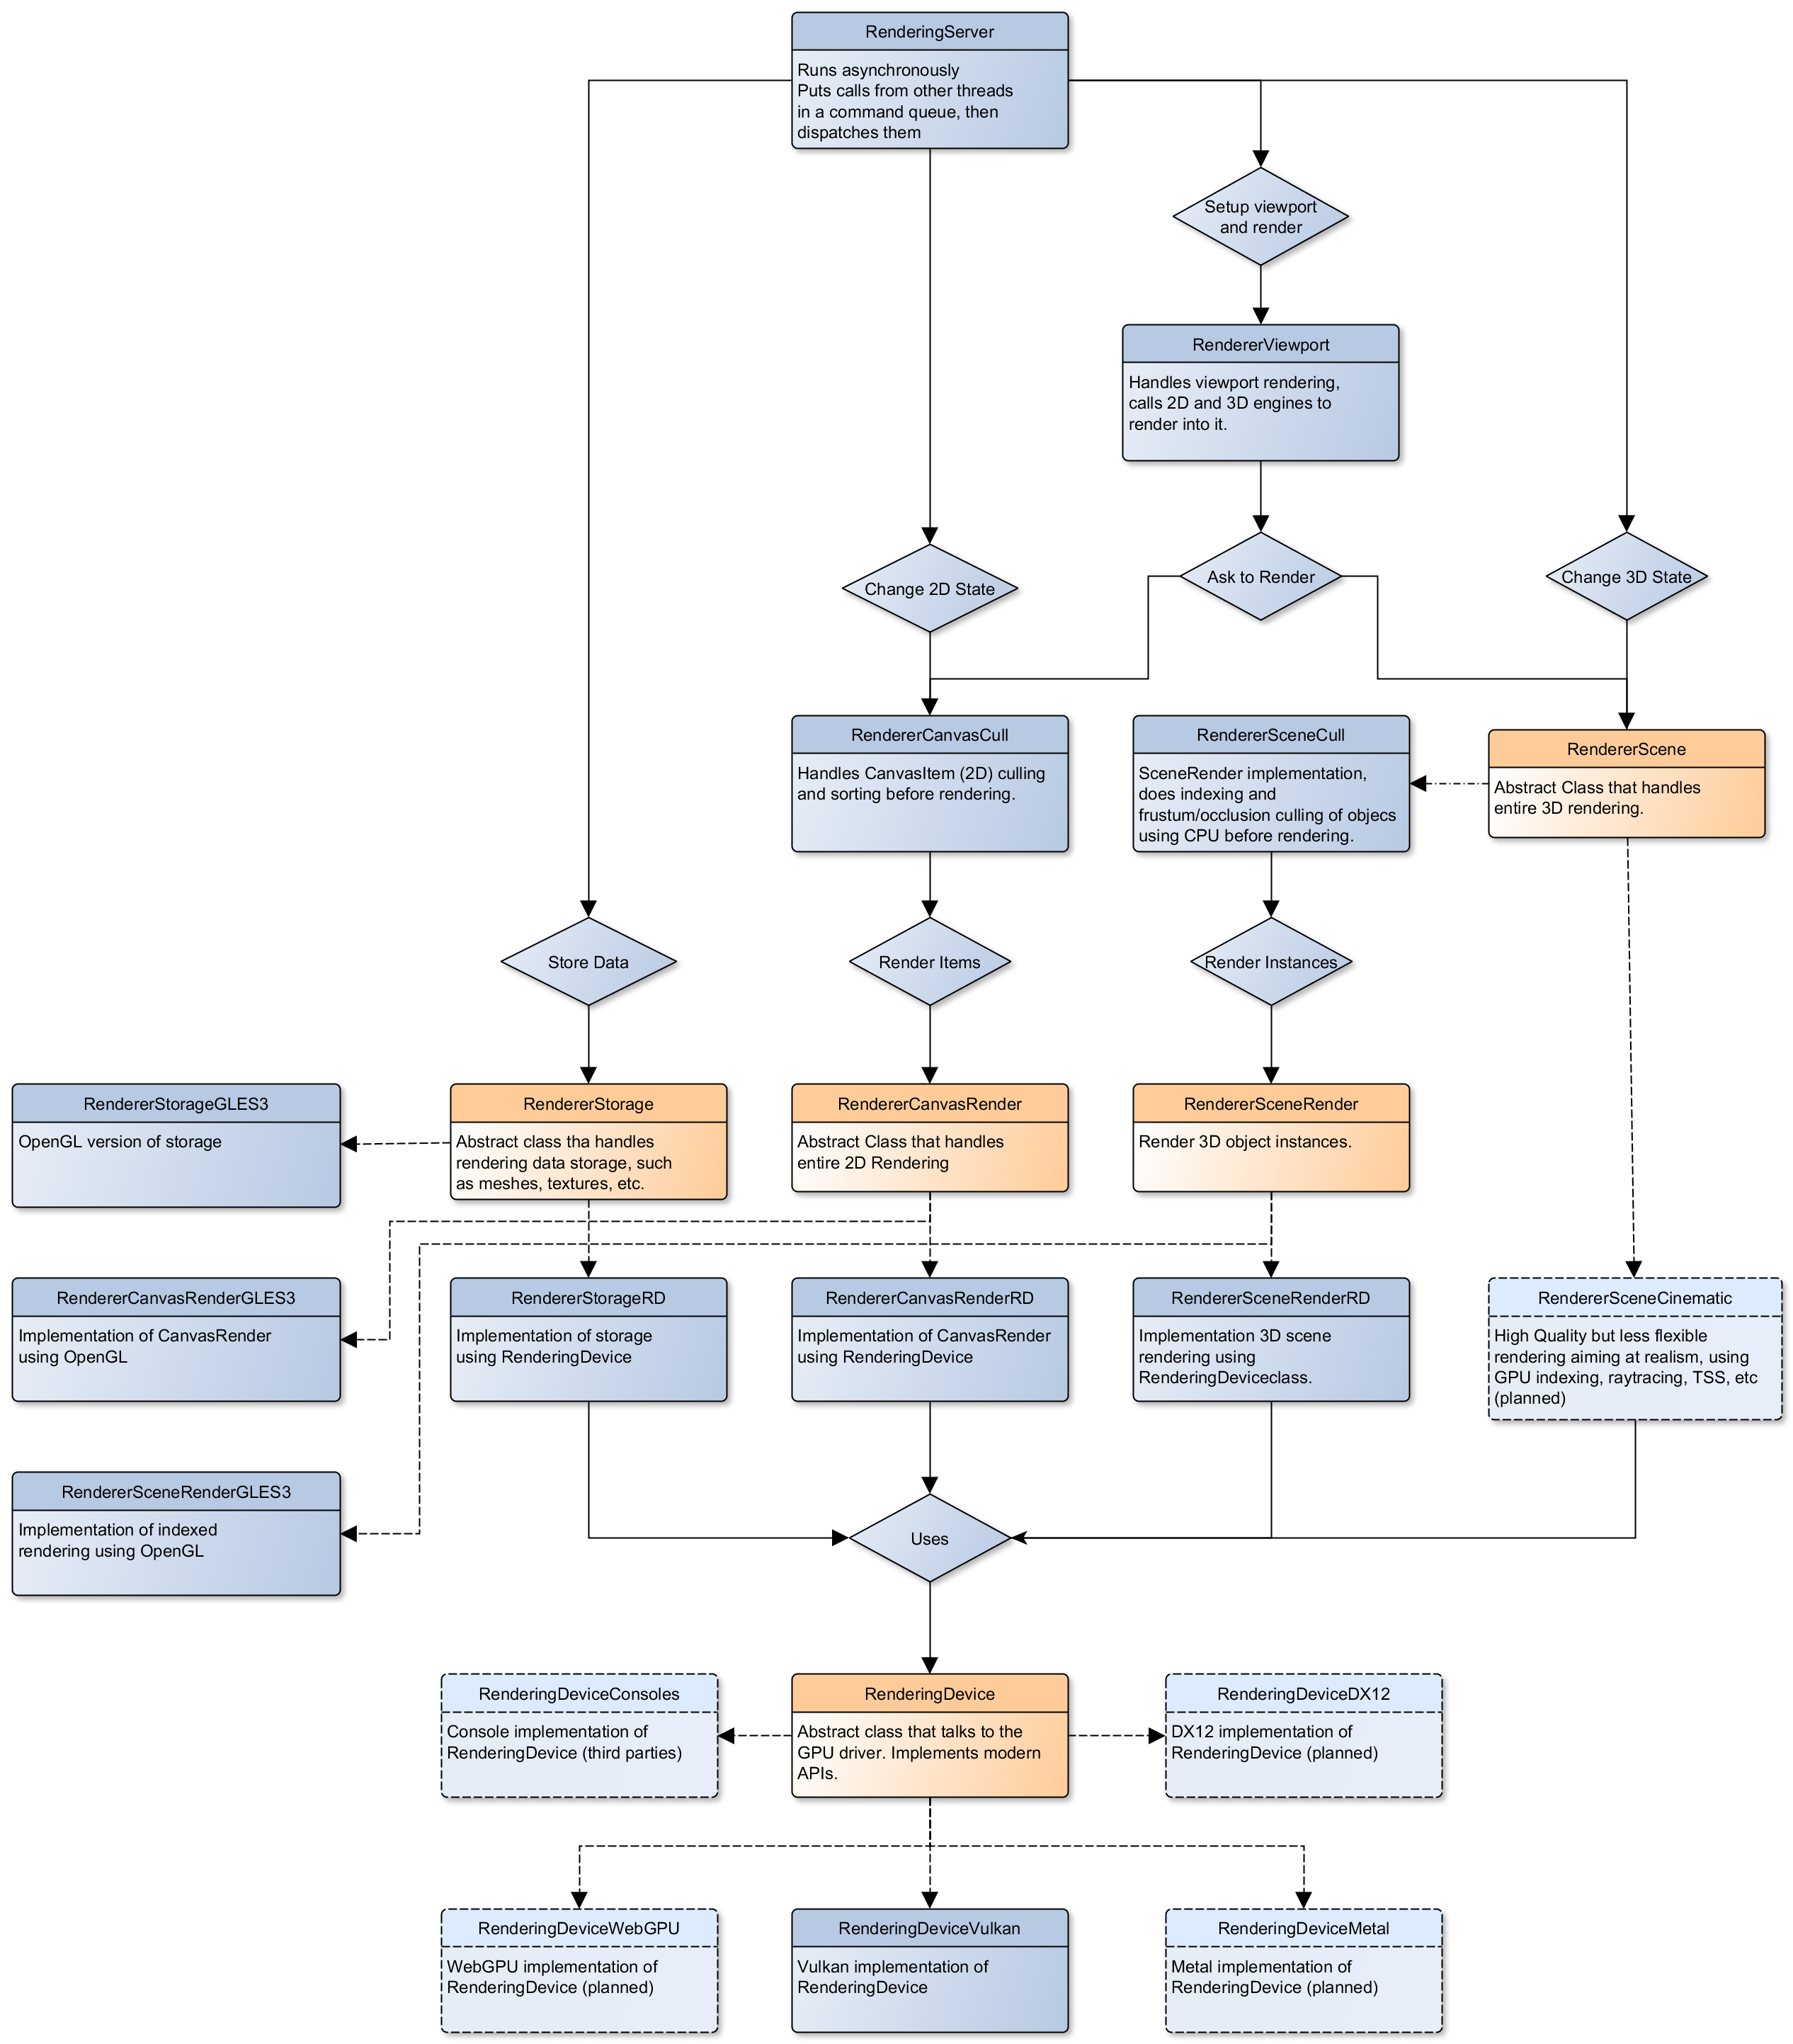
这张图表展示了 Godot 中渲染类(rendering classes)的结构,其中也包含了 RenderingDevice 这一抽象层。

核心着色器
虽然 Godot 项目中的着色器是使用一种受 GLSL 启发的自定义语言编写的,但核心着色器(core shaders)则是直接用 GLSL 编写的。
这些核心着色器在编译时会被嵌入到编辑器和导出模板的二进制文件中。因此,如果你想让你对这些 GLSL 着色器所做的任何修改生效,就需要重新编译编辑器或导出模板的二进制文件。
一些材质特性,比如高度映射(height mapping)、折射(refraction)和近端淡出(proximity fade),并不属于核心着色器(core shaders)的一部分。它们是在默认的 BaseMaterial3D 中,使用 Godot 的着色器语言(而不是 GLSL)来实现的。这是通过根据材质中启用的特性,程序化地生成所需的着色器代码来完成的。
按照惯例,文件名中带有 _inc 的着色器文件,通常会被包含(include)进其他的 GLSL 文件中,以便更好地实现代码复用。这是通过标准的 GLSL 预处理来实现的。
警告
核心材质着色器(Core material shaders)会被场景中的每一个材质所使用——无论是默认的 BaseMaterial3D 还是自定义的着色器。正因如此,这些着色器必须尽可能地保持简洁,以避免出现性能问题,并确保着色器的编译速度不会变得太慢。
如果你在着色器中使用 if 分支,性能可能会有所下降,因为着色器对 VGPR 的使用量会增加。即使在一帧画面中,所有的像素都判定为 true 或者都判定为 false (即走同一条分支),这种情况依然会发生。
如果你在代码中使用 #if 预处理器分支,场景中所需的着色器版本数量就会增加。在最坏的情况下,仅仅添加一个布尔值(boolean)的 #define ,就可能导致该场景中需要编译的着色器版本数量 翻倍 。在某些情况下,可以使用 Vulkan 特化常量(specialization constants)作为一种更快(但功能更受限)的替代方案。
这意味着,无论是修改核心着色器(core shaders)还是 BaseMaterial3D,在 Godot 中添加新的内置材质功能都存在很高的门槛。虽然 BaseMaterial3D 可以利用动态代码生成技术,只在启用某个功能时才包含对应的着色器代码,但这依然会导致项目在使用这些功能时,需要生成更多的着色器版本。而在复杂的 3D 场景中,这可能会让着色器编译带来的卡顿(stutter)问题变得更加明显。
查看 The Shader Permutation Problem 和 Branching on a GPU 博客文章。
核心 GLSL 材质着色器:
Forward+: servers/rendering/renderer_rd/shaders/forward_clustered/scene_forward_clustered.glsl
Mobile: servers/rendering/renderer_rd/shaders/forward_mobile/scene_forward_mobile.glsl
Compatibility: drivers/gles3/shaders/scene.glsl
材质着色器生成:
适用于 Forward+(正向+)和 Mobile(移动端)渲染方法的其他 GLSL 着色器:
Compatibility 渲染方法的其他 GLSL 着色器:
2D 与 3D 渲染的拆分
备注
以下内容仅适用于 Forward+(正向+)和 Mobile(移动端)渲染模式,在 Compatibility(兼容性)渲染模式下不适用。当使用兼容性渲染器时,可以通过使用多个视口(Viewports)来模拟这一效果,或者用它来实现 2D 分辨率缩放。
2D 和 3D 会被分别渲染到独立的缓冲区(buffers)中,这是因为 Godot 中的 2D 渲染是在 sRGB 色彩空间下的 LDR 中进行的,而 3D 渲染则使用的是线性空间下的 HDR 。
2D 渲染使用的颜色格式是 RGB8(如果视口(Viewport)的 透明(Transparent) 属性被开启,则使用 RGBA8)。3D 渲染使用的是 24 位无符号归一化整数深度缓冲区;如果硬件不支持 24 位深度缓冲区,则会退而使用 32 位有符号浮点数。另外,2D 渲染不使用深度缓冲区。
3D 分辨率缩放的具体执行方式,取决于你使用的是双线性缩放(bilinear)还是 FSR 1.0 缩放。当使用双线性缩放时,引擎不会运行任何特殊的升频着色器(upscaling shader)。相反,视口的纹理会被直接拉伸,并通过线性采样器(linear sampler)进行显示(这使得过滤操作直接在硬件层面上完成)。这种机制让双线性 3D 缩放的性能达到了最大化。
RenderSceneBuffersRD 中的 configure() 函数,会在分辨率或缩放比例发生改变时,重新分配(reallocates)2D 和 3D 的缓冲区。
目前暂不支持动态分辨率缩放,但有计划在未来 Godot 版本中加入。
2D 和 3D 渲染缓冲区配置 C++ 代码:
FSR 1.0:
2D 渲染技术
2D 光照渲染在单个阶段中进行,以便在场景中有大量光照时获得更高的性能。
所有渲染器都采用了 2D 批处理(2D batching)技术来提升性能,这一点在屏幕上显示大量文字时,效果尤为明显。
在 2D 渲染中,你可以开启 MSAA(多重采样抗锯齿)来实现 "自动" 的线条和多边形抗锯齿。不过,FXAA(快速近似抗锯齿)对 2D 渲染是无效的,因为它的计算是在 2D 渲染开始之前就已经完成了。另外,Godot 自带的 2D 绘图方法(比如 Line2D 节点,或者 CanvasItem 的一些 draw_*() 绘图方法)其实已经内置了自己的抗锯齿方案。它们通过三角形带(triangle strips)和顶点颜色来实现边缘平滑,所以这些方法本身并不依赖 MSAA 就能正常工作。
如果用户自定义的着色器(Shader)发出了请求,引擎就会自动在视口(Viewport)中生成一个代表所有 LightOccluder2D 节点的 2D 有向距离场。这个距离场可以在自定义着色器中用于实现各种特效,比如 2D 全局光照。此外,它也被用来计算 2D 场景中的粒子碰撞。
2D SDF 生成 GLSL 着色器:
3D 渲染技术
反向 Z
Godot 的所有渲染器都采用了反向 Z(Reverse Z)技术。这意味着深度缓冲区(Depth Buffer)是被反转的:其中 1.0 代表近裁剪面,而 0.0 代表远裁剪面。这种设置能够带来 更好的精度,尤其是在处理长距离(远景)渲染时效果显著。
分批和实例
在 Forward+(正向+)渲染器中,引擎使用了 Vulkan 实例化(instancing)技术,将相同的、不透明或经过 Alpha 测试的物体打包在一起进行渲染,以此来提升性能。(不过,采用 Alpha 混合的物体永远不会被实例化。)这种方式的渲染速度虽然比不上静态网格合并(static mesh merging),但它依然允许对每一个实例进行单独的视锥体剔除(culling)。
精灵、多边形和线条渲染
备注
兼容性渲染器(Compatibility renderer)目前不支持贴花(Decal)渲染。
Forward+(正向+)渲染器采用了‘聚类光照(clustered lighting)’技术。这使得你可以随心所欲地添加任意数量的光源,其性能开销主要取决于光源在屏幕上的覆盖面积。如果一个光源不需要投射阴影,并且它在屏幕上占用的面积不大,那么它的性能开销几乎可以忽略不计。
所有渲染方法都支持同时渲染最多 8 盏方向光(Directional Lights)。不过,如果有多于一盏的方向光开启了阴影,那么阴影的质量会有所降低。
移动端渲染器采用‘单次遍历(single-pass)’的光照渲染方式。它有一个限制:每个网格(Mesh) 资源 最多只能受到 8 个点光源(OmniLights)和 8 个聚光灯(SpotLights)的影响(此外,在同一个摄像机视野范围内,最多只能存在 256 个点光源和 256 个聚光灯)。这些限制是写死在引擎代码里的(hardcoded),无法在项目设置中进行调整。
兼容性渲染器采用了一种混合式的‘单次遍历 + 多次遍历’光照处理方式。不带阴影的光源会在单次遍历中完成渲染,而带阴影的光源则需要通过多次遍历来渲染。这是出于移动端设备性能方面的考量。因此,当场景中存在大量投射阴影的光源时,性能表现会急剧下降。建议在同一时间、同一摄像机视锥体内,只保留少数几个带阴影的光源,并且尽量让这些光源彼此隔开,确保每个物体在渲染时最多只被 1 到 2 个带阴影的光源照射到。可以在项目设置中调整单次可见的最大光源数量。
在所有这三种方法中,不带阴影的光照开销远低于带阴影的光照。为提升性能,光照只有在自身被修改或者范围内的物体被修改时才会更新。Godot 目前不分离静态和动态阴影渲染,但有计划在未来版本中加入这一特性。
在 Forward+(正向+)渲染器中,聚类技术也被应用到了反射探针(reflection probes)和贴花(decals)的渲染上。
区域光源(Area lights)运用了 线性变换余弦 技术。
阴影贴图
Forward+(正向+)和 Mobile(移动端)渲染器都采用了 PCF 技术来过滤阴影贴图,从而生成柔和的阴影半影(也就是阴影边缘的模糊过渡区)。不过,这两种方法并没有使用固定的 PCF 采样模式,而是采用了‘沃格尔盘(Vogel disk)’模式。这样做的好处是,不仅可以灵活调整采样数量,还能让画质的过渡变得更加平滑自然。
此外,Godot 还支持百分比渐进式软阴影(PCSS),能够渲染出更加逼真的阴影半影(即阴影边缘的柔和过渡区域)。不过,PCSS 阴影仅限于 Forward+(正向+)渲染器使用,因为它的计算开销实在太大,无法在 Mobile(移动端)渲染器中流畅运行。同时,PCSS 采用的是一种‘沃格尔盘(Vogel-disk)’形状的采样核。
此外,这两种阴影映射技术都会在逐像素的基础上旋转采样核(kernel),以帮助柔化采样不足所产生的瑕疵。
Compatibility 渲染器支持 DirectionalLight3D、OmniLight3D、SpotLight3D 的阴影贴图。
时间抗锯齿
备注
仅在 Forward+ 渲染器中可用,Mobile 和 Compatibility 渲染器中不可用。
Godot 采用一套基于旧版 Spartan Engine TAA 的实现方法。
Temporal antialiasing 需要依靠运动矢量才能正常工作。如果运动矢量没有正确生成,那么当摄像机或物体移动时,画面上就会出现‘鬼影’。
运动矢量是在 GPU 的主材质着色器(Main Material Shader)中生成的。具体的做法是:除了运行当前渲染帧的顶点着色器(使用当前的摄像机变换矩阵)之外,还会额外运行上一帧的顶点着色器(使用上一帧的摄像机变换矩阵),然后将两者计算出的位置差值,存储在一个颜色缓冲区(Color Buffer)里。
另外,FSR 2.2 也可以作为一种画面放大(Upscaling)方案来使用,它同时也自带了一套时间性抗锯齿(TAA)算法。FSR 2.2 是建立在 RenderingDevice(渲染设备)抽象层之上实现的,而不是直接照搬使用 AMD 官方的参考代码。
TAA 解析:
FSR 2.2:
全局光照
备注
VoxelGI 和 SDFGI 仅在 Forward+(正向+)渲染器中可用,在 Mobile(移动端)或 Compatibility(兼容性)渲染器中则无法使用。
LightmapGI 的 烘焙(baking) 功能仅在 Forward+(正向+)和 Mobile(移动端)渲染器下可用,并且只能在编辑器内部进行(无法在导出的游戏项目里执行)。而 LightmapGI 的 渲染(rendering) 功能则支持 Compatibility(兼容性)渲染器。
Godot 支持基于体积像素的全局光照 (VoxelGI),带符号距离场全局光照 (SDFGI) 和光照贴图烘焙与渲染 (LightmapGI)。如果想要的话,可以同时使用多种方案。
光照贴图的烘焙是利用 Vulkan 计算着色器在 GPU(显卡)上进行的。这套基于 GPU 的光照贴图工具是在 LightmapperRD 类中实现的,而该类继承自 Lightmapper 类。这样的设计使得开发者能够在此基础上实现更多的光照贴图工具,也为未来移植 Godot 3.x 版本中基于 CPU 的光照贴图工具铺平了道路。这样一来,即便在使用兼容性渲染器(Compatibility renderer)时,也能正常烘焙光照贴图。
核心 GI C++ 代码:
scene/3d/voxel_gi.cpp - VoxelGI 节点
editor/scene/3d/voxel_gi_editor_plugin.cpp - VoxelGI 节点的编辑器界面
核心 GI GLSL 着色器:
servers/rendering/renderer_rd/shaders/environment/voxel_gi.glsl
servers/rendering/renderer_rd/shaders/environment/voxel_gi_debug.glsl - VoxelGI 调试绘制模式
servers/rendering/renderer_rd/shaders/environment/sdfgi_debug.glsl - SDFGI 级联(Cascades)调试绘制模式
servers/rendering/renderer_rd/shaders/environment/sdfgi_debug_probes.glsl - SDFGI 探针(Probes)调试绘制模式
servers/rendering/renderer_rd/shaders/environment/sdfgi_integrate.glsl
servers/rendering/renderer_rd/shaders/environment/sdfgi_preprocess.glsl
servers/rendering/renderer_rd/shaders/environment/sdfgi_direct_light.glsl
光照贴图器 C++ 代码:
scene/3d/lightmap_gi.cpp - LightmapGI 节点
editor/scene/3d/lightmap_gi_editor_plugin.cpp - LightmapGI 节点的编辑器界面
scene/3d/lightmapper.cpp - 抽象类
modules/lightmapper_rd/lightmapper_rd.cpp - 基于 GPU 的光照贴图(lightmapper)实现
光照贴图器 GLSL 着色器:
景深
备注
该功能仅适用于 Forward+ 和移动渲染器,不适用于兼容性渲染器。
Forward+(正向+)和 Mobile(移动端)渲染器采用了不同的景深渲染方式,因此呈现出的视觉效果也会有所不同。这样做是为了让特效最好地适配目标硬件的性能特性。在 Forward+ 中,景深是通过计算着色器(compute shader)来完成的;而在 Mobile 中,景深则是通过片段着色器(fragment shader,也就是传统的光栅化方式)来实现的。
系统提供了方形、六边形和圆形三种散景(Bokeh)形状供你选择(性能消耗从快到慢)。另外,如果启用了时间性抗锯齿(Temporal Antialiasing),还可以选择对景深效果进行逐帧抖动处理,从而让画面看起来更自然。
景深 C++ 代码:
景深 GLSL 着色器(计算 - 用于 Forward+)
景深 GLSL 着色器(光栅化 - 适用于 Mobile 移动端渲染后端):
屏幕空间效果(SSAO、SSIL、SSR、SSS)
备注
仅在 Forward+ 渲染器中可用,Mobile 和 Compatibility 渲染器中不可用。
Forward+ 渲染器支持屏幕空间环境光遮蔽、屏幕空间间接光照、屏幕空间反射以及次表面散射。
SSAO 采用的是衍生自英特尔(Intel) ASSAO 的实现方案(并已被转换为 Vulkan 接口)。而 SSIL 则是基于 SSAO 衍生而来的,旨在提供高性能的间接光照效果。
当SSAO和SSIL都启用时,SSAO和SSIL的部分区域将被共享以减少性能影响。
默认情况下,SSAO、SSIL 和 SSR 都会以一半的分辨率来进行计算,以此来提升性能。
SSR 利用 Hi-Z 缓冲区来提升性能。该 Hi-Z 缓冲区是在计算着色器中由深度缓冲区生成的。更多信息请参见全面修改 SSR 的 pull request。
屏幕空间效果 C++ 代码:
屏幕空间环境光遮蔽 GLSL 着色器:
servers/rendering/renderer_rd/shaders/effects/ssao_blur.glsl
servers/rendering/renderer_rd/shaders/effects/ssao_interleave.glsl
servers/rendering/renderer_rd/shaders/effects/ssao_importance_map.glsl
屏幕空间间接光照 GLSL 着色器:
servers/rendering/renderer_rd/shaders/effects/ssil_blur.glsl
servers/rendering/renderer_rd/shaders/effects/ssil_interleave.glsl
servers/rendering/renderer_rd/shaders/effects/ssil_importance_map.glsl
屏幕空间反射 GLSL 着色器:
servers/rendering/renderer_rd/shaders/effects/screen_space_reflection.glsl
servers/rendering/renderer_rd/shaders/effects/screen_space_reflection_filter.glsl
servers/rendering/renderer_rd/shaders/effects/screen_space_reflection_resolve.glsl
servers/rendering/renderer_rd/shaders/effects/screen_space_reflection_hiz.glsl
servers/rendering/renderer_rd/shaders/effects/screen_space_reflection_downsample.glsl
次表面散射 GLSL:
天空渲染
参见
Godot 支持使用着色器(shader)来渲染天空背景。辐射图(radiance map)会根据天空着色器自动更新,它的作用是为 PBR(基于物理的渲染)材质提供环境光和反射效果。
SkyMaterial 资源(比如 ProceduralSkyMaterial、PhysicalSkyMaterial 和 PanoramaSkyMaterial)会为天空渲染自动生成一个内置的着色器(shader)。这其实和 BaseMaterial3D 为普通 3D 场景材质提供的功能是类似的。
关于详细的技术实现细节,可以在 Custom sky shaders in Godot 4.0 这篇文章里找到。.
天空渲染 C++ 代码:
servers/rendering/renderer_rd/environment/sky.cpp - Sky rendering
scene/resources/sky.cpp - Sky resource (请勿与天空渲染混淆)
scene/resources/3d/sky_material.cpp SkyMaterial(天空材质)资源(在 Sky 天空资源中使用)
天空渲染 GLSL 着色器:
体积雾
备注
仅在 Forward+ 渲染器中可用,Mobile 和 Compatibility 渲染器中不可用。
参见
Godot 支持一种‘视锥体对齐体素’(frustum-aligned voxel,简称 froxel)的方法来进行体积雾渲染。与传统的后处理滤镜(post-processing filter)不同,这种方法的通用性更强,可以兼容任意类型的光源。此外,雾还可以使用着色器(shader)来实现自定义效果,比如让雾动起来,或者使用 3D 纹理来表现雾的密度变化。
FogMaterial(雾材质)资源会为 FogVolume(雾体积)节点自动生成一个内置的着色器(shader)。这其实和 BaseMaterial3D 为普通 3D 场景材质提供的功能是类似的。
关于详细的技术原理解释,可以查阅 Fog Volumes arrive in Godot 4.0 这篇文章。
体积雾 C++ 代码:
scene/3d/fog_volume.cpp - FogVolume 节点
scene/resources/3d/fog_material.cpp - FogMaterial resource (用于 FogVolume)
体积雾 GLSL 着色器:
遮挡剔除
虽然现代 GPU(显卡)处理大量三角形的绘制已经绰绰有余,但在复杂的场景中,绘制调用(draw calls)的数量依然可能成为性能的瓶颈(即便是在使用 Vulkan、Direct3D 12 和 Metal 这些现代图形 API 的情况下,也不例外)。
Godot 4 支持遮挡剔除(occlusion culling),这不仅能减少过度绘制(overdraw,在深度预通道被禁用的情况下),还能降低顶点处理量。这项功能是通过使用 Embree 在 CPU 上光栅化一个低分辨率的缓冲区来实现的。该缓冲区的分辨率取决于系统上的 CPU 线程数量,因为这一过程是并行处理的。这个缓冲区包含了在编辑器中预烘焙好或在运行时动态创建的遮挡体形状。为了帮助减少欠采样产生的瑕疵,遮挡剔除缓冲区在每一帧都会进行微小的抖动,这能有效避免出现误判(即物体在不该被遮挡的时候被错误地剔除)。
由于复杂的遮挡体会给 CPU 带来极大的负担,因此在编辑器中生成烘焙遮挡体(baked occluders)时,系统可以自动对它们进行简化。
Godot 的遮挡剔除目前还不支持动态遮挡体,不过你依然可以切换 OccluderInstance3D 节点的显示/隐藏状态,或者移动它们。但需要注意的是,如果用这种方式去更新复杂的遮挡体,速度会比较慢。因此,如果需要在游戏运行时更新遮挡体,最好只针对简单的遮挡体形状(比如四边形或立方体)来进行操作。
这种基于CPU的方法与其他解决方案相比有一些优势,如门户和房间或基于GPU的剔除解决方案:
不需要手动设置(但可以手动调整以获得最佳性能)。
没有帧延迟,这在摄像机切换期间的过场动画中或者当摄像机在墙后快速移动时是有问题的。
适用于所有渲染驱动程序和方法,不会因驱动程序或GPU硬件而出现不可预测的行为。
遮挡剔除是通过注册遮挡体网格(occluder meshes)来实现的,这一步通常借助 OccluderInstance3D 节点 来完成(而这些节点内部使用的是 Occluder3D 资源 )。随后,RenderingServer(渲染服务器)会通过调用 RendererSceneOcclusionCull 里的 Embree 库,来实际执行遮挡剔除的计算。
遮挡剔除 C++ 代码:
可见范围(LOD)
Godot支持手动创作的层次细节层次(HLOD),距离由用户在检查器中指定。
在 RenderingSceneCull 类中, _scene_cull() 和 _render_scene() 这两个函数是处理 LOD(细节层次)判断的核心所在。每个视口(Viewport)都可以使用不同的 LOD 来渲染同一个网格(这是为了确保分屏渲染时画面能正常显示)。
可见性范围(Visibility range)的 C++ 代码:
自动网格 LOD
ImporterMesh 类用于编辑器中的 3D 网格导入工作流。它的 generate_lods() 函数使用 meshoptimizer 库来处理生成。
LOD 网格在生成的同时,也会一并生成对应的阴影网格。这些阴影网格有个特点:不管模型原本是怎么平滑着色或划分材质的,它都会把所有的顶点直接‘焊接’到一起。这样做主要是为了提升阴影的渲染性能,通过降低渲染阴影时所需的顶点处理量,来让游戏跑得更流畅。
RenderingSceneCull 类的 _render_scene() 函数,负责在渲染时决定具体应该使用哪个级别的网格 LOD(细节层次)。每个视口(Viewport)都可以使用不同的 LOD 来渲染同一个网格(这是为了确保分屏渲染时画面能正常显示)。
网格 LOD(细节层次)会根据屏幕覆盖率的指标来自动选择。这个过程会自动把分辨率以及摄像机视场角(FOV)的变化考虑在内,完全不需要用户手动干预。另外,相关的阈值乘数可以在项目设置中进行调整。
为了提高性能,阴影渲染和反射探测渲染也选择自己的网格LOD阈值(可以不同于主场景渲染)。
导入时的网格 LOD 生成(C++ 代码):
网格 LOD 确定的 C++ 代码: